Краткое резюме
- SEO-архитектура распределяет поисковый спрос между смысловыми объектами и страницами сайта.
- Её основа — не дерево URL, а цепочка: спрос → интент → смысловой объект → роль страницы → иерархия.
- Бизнес-структура описывает устройство компании, а SEO-структура — задачи, с которыми пользователи приходят в поиск.
- Страница должна иметь определённую ответственность: представлять конкретный объект, решать основной интент и занимать понятное место среди других документов.
- Внутренние ссылки выражают отношения и приоритеты, но не исправляют неверно назначенные роли.
- Архитектурные проблемы проявляются как конкуренция страниц, перегрузка одной страницы несовместимыми задачами или отсутствие страницы для значимого интента.
- Результат диагностики — не универсальный SEO Score, а карта архитектурных решений.
Вступление
Сайт может выглядеть упорядоченным для команды и при этом оставаться неоднозначным для поисковой системы. В меню есть услуги, каталог разбит на разделы, статьи распределены по рубрикам, а у каждой страницы — аккуратный URL. Но по одним запросам ранжируется не та страница, по другим поисковик чередует несколько URL, а часть значимых направлений почти не получает показов.
Причина часто находится не в оформлении структуры, а в распределении ответственности между страницами. Поисковой системе недостаточно увидеть дерево разделов. Ей нужно сопоставить документы с пользовательскими задачами, понять, какие темы и объекты для сайта основные, отличить общую страницу от частной и восстановить отношения между услугой, категорией, продуктом, статьёй и кейсом.
В Leadstream мы описываем этот механизм моделью поисковой архитектуры Demand-to-Hierarchy («от спроса к иерархии»). Эта модель не является официальной формулой ранжирования, а служит способом диагностировать, насколько последовательно сайт переводит поисковый спрос в систему страниц. Она помогает отделить архитектуру от её внешних проявлений — меню, URL и ссылок — и принимать решения на основании запросов, выдачи, фактических посадочных страниц и содержания сайта.
Что на самом деле организует SEO-архитектура сайта?
SEO-архитектура организует не адреса, а поисковое представление бизнеса, определяя, какие пользовательские задачи сайт способен закрыть, какие смысловые объекты для этого созданы и какая страница отвечает за каждый из них.
У архитектуры есть три разных слоя.
Три слоя SEO-архитектуры
| Слой | Что в него входит | На какой вопрос отвечает |
|---|---|---|
| Смысловой | Спрос, интент, темы, сущности, задачи | Что именно должен представлять сайт? |
| Страничный | Роли документов и отношения между ними | Какая страница за что отвечает? |
| Технический | URL, навигация, внутренние ссылки, sitemap | Как страницы обнаруживаются и как выражены их связи? |
Технический слой важен, но он не создаёт смысловую логику автоматически. Если две страницы одинаково описывают одну услугу, аккуратные URL не разделят их ответственность. Если категория объединяет товары только по внутренней классификации поставщика, но не соответствует самостоятельной задаче пользователя, дополнительный уровень меню не сделает её полноценной поисковой страницей.
Поэтому дерево URL может совпадать с SEO-архитектурой, но не является её определением. Например, в руководстве Google для e-commerce-сайтов указано, что связи между страницами помогают понять устройство сайта и относительную важность документов, а в рекомендациях Яндекса по структуре сайта подчёркивается значение ссылок между страницами для обнаружения документов и анализа структуры.
Это не означает, что понятные адреса бесполезны. Они помогают пользователю ориентироваться, упрощают управление сайтом и могут давать дополнительный контекст. Но основной архитектурный вопрос звучит иначе: можно ли по совокупности содержания и связей установить ответственность каждой страницы?
Почему бизнес-структура и SEO-структура не совпадают автоматически?
Бизнес описывает себя через собственное устройство: подразделения, продуктовые линии, технологии, форматы работы и зоны ответственности. Пользователь начинает с другой стороны — с проблемы, объекта выбора или результата, который хочет получить.
Например, агентство может делить услуги между отделами контекстной рекламы, SEO и аналитики. Пользователь при этом ищет не отдел, а решение: снизить стоимость обращения, восстановить трафик после падения, проверить подрядчика или понять, почему реклама не приводит продажи. Производитель может строить каталог по сериям и внутренним кодам, тогда как покупатель выбирает по назначению, совместимости или условиям эксплуатации.
Обе структуры обоснованны, но отвечают на разные вопросы.
Бизнес-структура и SEO-структура
| Бизнес-структура | SEO-структура |
|---|---|
| Как компания организует продукты и работу | Как пользователи формулируют задачи и различают решения |
| Кто внутри отвечает за направление | Какая страница отвечает на определённый интент |
| Как устроен ассортимент или процесс | Какие смысловые объекты должны быть представлены отдельно |
| Какие названия приняты внутри компании | Какие формулировки понятны рынку и используются в поиске |
| Как удобно управлять контентом | Как документы должны соотноситься в поисковом представлении |
SEO-архитектура не должна механически копировать ни поисковые запросы, ни организационную схему. Если создавать отдельный URL под каждую формулировку, близкие запросы быстро превращаются в дублирующиеся страницы. Если полностью перенести на сайт внутренний каталог, пользователь может не узнать в нём свою задачу.
Рабочая архитектура соединяет обе стороны. Она сохраняет реальные предложения, ограничения и продуктовую модель бизнеса, но представляет их через различимые пользовательские задачи. Поэтому её проектирование начинается не с вопроса «какие разделы добавить в меню», а с сопоставления спроса, интентов и объектов, которые бизнес действительно может представить.
Как спрос превращается в архитектуру сайта?
Центральная модель описывает пять разных решений:
спрос → интент → смысловой объект → роль страницы → иерархия
Пять элементов модели поисковой архитектуры
| Элемент | Что нужно установить | Типичная ошибка |
|---|---|---|
| Спрос | Какие задачи и формулировки существуют в поиске | Считать каждую фразу отдельной темой |
| Интент | Какого результата ожидает пользователь | Объединять запросы только по словам |
| Смысловой объект | Какой устойчивый объект или проблема стоит за запросами | Создавать страницы без самостоятельного предмета |
| Роль страницы | Какая страница должна представлять смысловой объект и решать задачу | Путать роль с шаблоном страницы |
| Иерархия | Как документ связан с основными, дочерними и поддерживающими страницами | Считать иерархией только вложенность URL |
Спрос даёт наблюдаемый материал: запросы, их частотность, формулировки, сезонность и состав выдачи. Но он ещё не говорит, сколько страниц требуется. Разные запросы могут выражать одну задачу, а одинаковые слова — скрывать разные намерения.
Интент отвечает на вопрос, что пользователь хочет сделать: получить объяснение, выбрать вариант, сравнить решения, заказать услугу, найти конкретный продукт или проверить совместимость. Интент нельзя надёжно определить по одному слову. Для вывода сопоставляются формулировка, выдача, типы ранжирующихся страниц и реальное содержание предложений.
Подробнее механизм распознавания пользовательской задачи разобран в статье «Интент в SEO и контент-маркетинге». Следующий архитектурный вопрос — какой документ должен отвечать за выявленный интент и как он соотносится с соседними страницами. Здесь интент рассматривается уже как вход для архитектурного решения.
Смысловой объект фиксирует, о чём должна быть страница. Это может быть услуга, товарная категория, модель продукта, проблема, метод, сценарий применения или другое устойчивое понятие. Смысловой объект удерживает архитектуру от механического размножения страниц: несколько формулировок могут относиться к одному объекту, если пользовательская задача и ожидаемый ответ совпадают.
Роль страницы назначает ответственность конкретному документу. Страница может быть основной для направления, представлять частную услугу, объединять класс продуктов, объяснять механизм, сравнивать решения или подтверждать опыт. Здесь определяется не только содержание, но и границы: что документ должен раскрывать и какие задачи принадлежат другим страницам.
Иерархия связывает роли. Она показывает, какой документ представляет более широкий смысловой объект, какие страницы раскрывают его части, какие помогают сделать выбор и какие подтверждают утверждения. Иерархия существует не потому, что один URL короче другого, а потому, что между страницами установлены отношения общего и частного, основного и поддерживающего.
Переходы нельзя пропускать. Частотный запрос без анализа интента не обосновывает новую страницу. Интент без смыслового объекта не определяет устойчивый объект. Смысловой объект без роли страницы остаётся темой без ответственного документа. Отдельные роли без иерархии превращаются в набор страниц, между которыми поисковой системе приходится самостоятельно восстанавливать отношения.
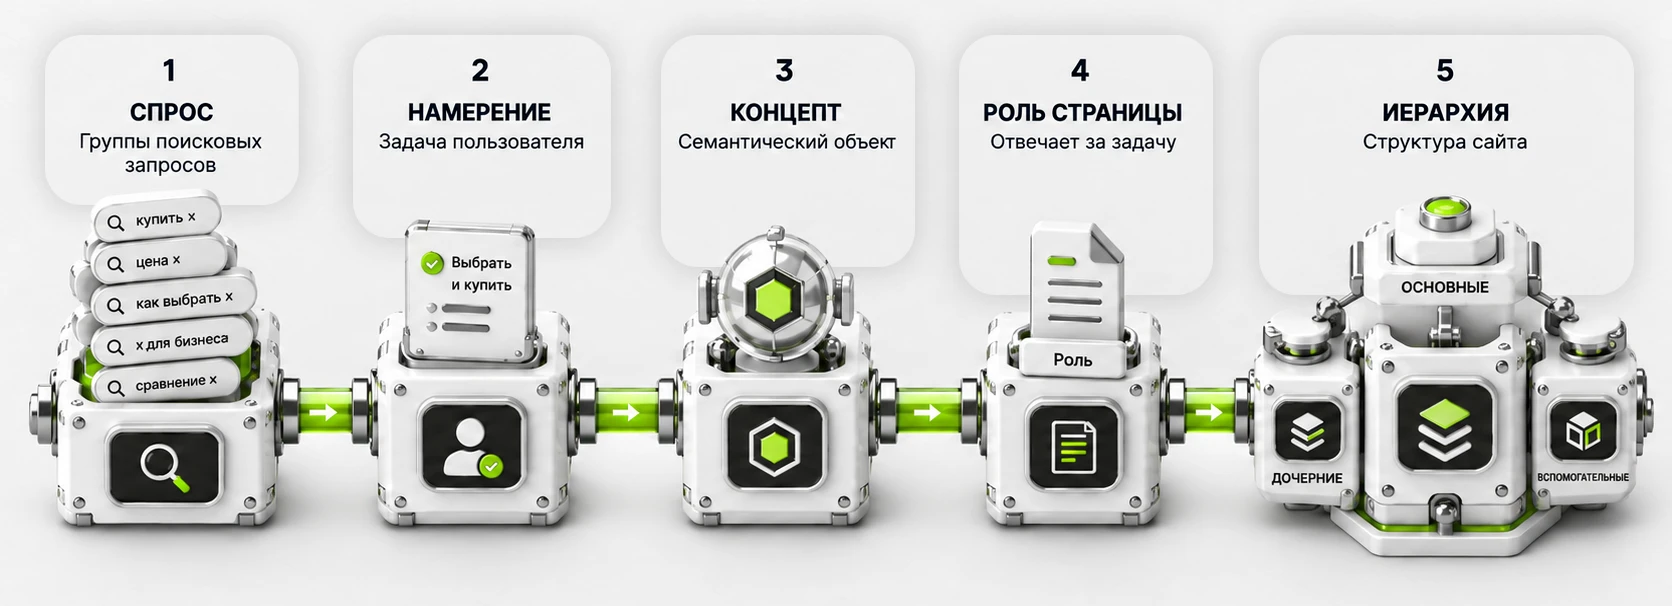
Demand-to-Hierarchy показывает переход от наблюдаемого поискового спроса к системе основных, дочерних и поддерживающих страниц.
Что такое «роль страницы» и чем роль отличается от типа страницы?
Роль страницы — это ответственность страницы в поисковой архитектуре: какой смысловой объект она представляет, какой основной интент закрывает и как соотносится с другими документами.
Тип страницы отвечает прежде всего за формат. Это может быть категория, карточка продукта, страница услуги, статья или кейс. Роль объясняет, зачем этот документ существует в системе.
Одинаковый шаблон не означает одинаковую роль. Две страницы услуг могут выглядеть одинаково, но одна представляет основное направление, а другая — частный сценарий внутри него. Две статьи могут иметь один редакционный формат, но первая объясняет базовое понятие, а вторая сравнивает варианты перед коммерческим выбором.
И наоборот, похожую роль иногда выполняют страницы разных типов. На одном сайте основным документом по продуктовой группе будет категория, на другом — подробная посадочная страница, если ассортимент фактически является одной конфигурируемой системой.
Для назначения роли нужно установить четыре параметра:
- объект: о чём именно страница;
- основной интент: какую задачу она должна решать;
- граница: какие соседние вопросы она сознательно не забирает;
- отношения: какие страницы находятся выше, ниже или поддерживают её.
Роль не должна быть искусственно узкой. Отдельная страница оправдана не наличием одного запроса, а самостоятельной пользовательской задачей и достаточным содержанием для её решения. Но роль не должна быть и бесконечно широкой. Если документ одновременно пытается объяснить тему, продать несколько разных услуг, сравнить продукты и закрыть региональные запросы, его основную ответственность становится трудно определить.
Полезный диагностический вопрос звучит так: если убрать название шаблона и посмотреть только на содержание, можно ли одним предложением объяснить, за какой выбор или ответ отвечает эта страница? Если формулировка распадается на несколько несовместимых задач, роль, вероятно, перегружена. Если одинаковая формулировка подходит нескольким URL, роли недостаточно различимы.
Как должны соотноситься страницы услуг, категорий и статей?
Страницы разных типов не должны существовать параллельными наборами. Их задача — представлять разные стороны одной предметной области и передавать пользователя между объяснением, выбором и действием.
Страница направления представляет широкий коммерческий смысловой объект. Она объясняет, какую группу задач решает бизнес, из каких частных услуг или продуктов состоит предложение и кому подходит каждый вариант.
Страница услуги отвечает за конкретное предложение и коммерческий интент: что получает клиент, в каких условиях, для каких задач и с какими ограничениями. Она не обязана повторять все теоретические объяснения, если они вынесены в связанные материалы.
Категория объединяет объекты по значимому для выбора признаку. Её роль — не просто перечислить карточки, а помочь понять состав группы и перейти к подходящему варианту. Если объединение существует только в базе данных и ничего не значит для пользователя, поисковая роль категории остаётся слабой.
Карточка продукта представляет конкретный объект: модель, товар, тариф или конфигурацию. Она должна отличать его от категории и соседних вариантов, а не повторять общий текст линейки.
Статья раскрывает информационную задачу: объясняет понятие, механизм, критерии выбора, ограничение или способ диагностики. Она поддерживает коммерческую страницу, когда помогает пользователю понять решение, но не должна маскироваться под неё только ради поискового спроса.
Кейс показывает применение в определённых условиях. Его архитектурная функция — подтвердить опыт и связать задачу, метод и результат. Кейс не заменяет описание услуги: единичный проект не определяет всё предложение.
Отношения между этими страницами можно описать глаголами:
- направление содержит частные услуги;
- категория объединяет продукты;
- продукт относится к категории;
- статья объясняет смысловой объект или проблему;
- сравнение помогает выбрать между вариантами;
- кейс подтверждает применение услуги или метода;
- коммерческая страница предлагает решение задачи.
Такая формулировка важнее близости URL. Она показывает, почему две страницы должны существовать отдельно и какая связь между ними полезна. Если отношение нельзя назвать, возможно, один из документов не имеет самостоятельной роли или связь создана только для технической перелинковки.
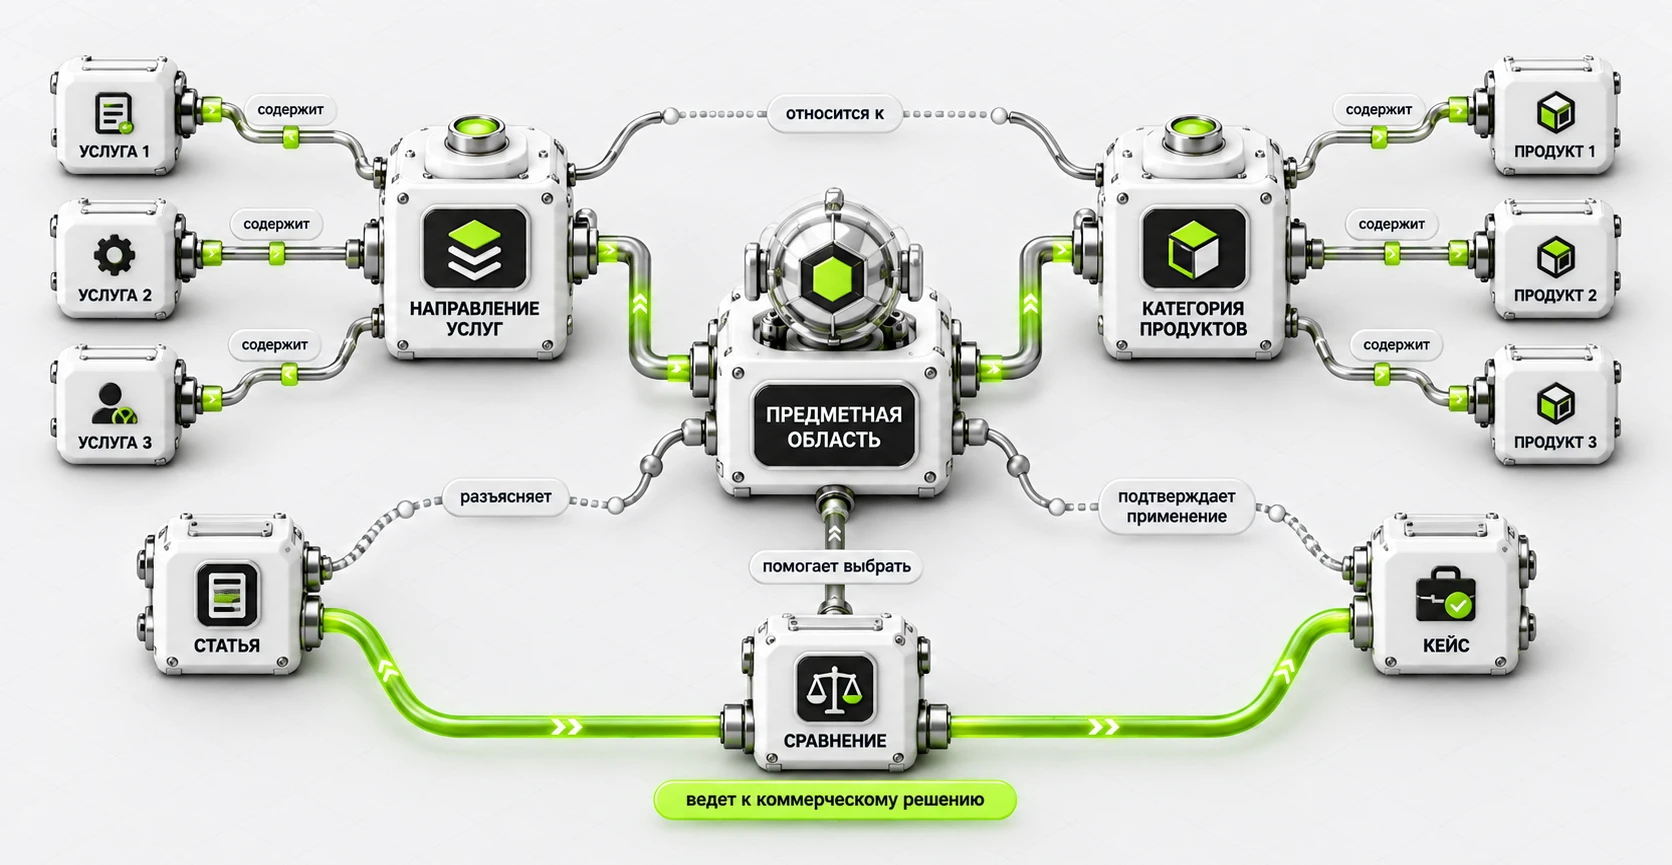
Страницы образуют архитектуру не только через вложенность: каждая связь должна объяснять, как один документ содержит, раскрывает, поддерживает или подтверждает другой.
Что делает одну страницу главной, а другую поддерживающей?
Главная страница по теме — не обязательно та, что находится ближе всего к корню сайта. Основной становится страница, которой последовательно назначена ответственность за смысловой объект и соответствующий интент.
Её положение формируется совокупностью признаков:
- документ прямо и полно представляет основной объект;
- заголовок, содержание и предложение соответствуют одной задаче;
- более частные страницы раскрывают отдельные варианты или аспекты;
- поддерживающие материалы ссылаются на неё в подходящем контексте;
- навигация не создаёт несколько равнозначных центров по одной теме;
- фактические поисковые данные подтверждают или опровергают назначенную роль.
Поддерживающая страница решает другую, но связанную задачу. Например, статья о критериях выбора помогает пользователю понять коммерческую страницу, а кейс подтверждает применимость услуги. Она не становится «второстепенной» по качеству: её функция просто отличается.
В рекомендациях Google для e-commerce-сайтов сообщается, что связи между страницами помогают понять устройство сайта и относительную важность документов. Там же отмечено, что структура URL обычно не используется как основной способ понять структуру сайта.
Из этого не следует универсальная формула: например, «важная страница должна находиться не глубже третьего уровня». Один и тот же путь кликов может иметь разный смысл на небольшом сайте услуг и в каталоге с тысячами товаров. Глубина становится диагностическим сигналом только в контексте: соответствует ли фактическая доступность страницы её назначенной роли и есть ли у пользователя естественный путь к ней.
Иерархия также не обязана быть строгим деревом. Статья может поддерживать несколько связанных услуг, продукт — входить в категорию и одновременно относиться к сценарию применения, а кейс — подтверждать метод и отраслевую компетенцию. Важно не свести все связи к одной родительской ветке, а сохранить различимые роли и понятные отношения.
Почему доступность для обхода — только один слой архитектуры?
Поисковая система не сможет учитывать страницу, о существовании которой не знает. Поэтому обнаружение документов и обычные ссылки остаются обязательной частью архитектуры. Google рекомендует делать значимые страницы доступными по обычным ссылкам, а в рекомендациях Яндекса по структуре сайта указано, что документы без внутренних ссылок могут остаться неизвестны роботу.
Но обнаружение отвечает только на первый вопрос. Полная архитектурная цепочка выглядит шире:
Пять состояний страницы в архитектуре
| Состояние | Диагностический вопрос |
|---|---|
| Открытие | Может ли робот найти URL? |
| Индексируемость | Может ли документ участвовать в индексе? |
| Интерпретация | Понятны ли его объект и основная задача? |
| Дифференциация | Отличается ли его роль от соседних страниц? |
| Иерархия | Понятно ли место документа в системе? |
Страница может быть доступна по ссылкам и оставаться архитектурно слабой. Например, робот найдёт две посадочные страницы, но их содержание будет описывать одну услугу без различимых условий. Или обнаружит категорию, которая содержит товары, но не объясняет принцип объединения и не отвечает на самостоятельную задачу.
Обратная ситуация тоже возможна: документ имеет ясную роль и качественное содержание, но существует только в sitemap или открывается через внутренний поиск. Тогда смысловая часть подготовлена, а механизм обнаружения не соответствует значению страницы.
Техническая доступность необходима, но не гарантирует индексирование или показ. Google Search Essentials отделяет технические требования и рекомендации от фактического решения просканировать, проиндексировать или показать документ. Поэтому SEO-архитектуру нельзя оценивать только краулером: он показывает пути и статусы, но не определяет, правильно ли распределены пользовательские задачи. Практический технический контур такой проверки разобран в руководстве по SEO-аудиту сайта.
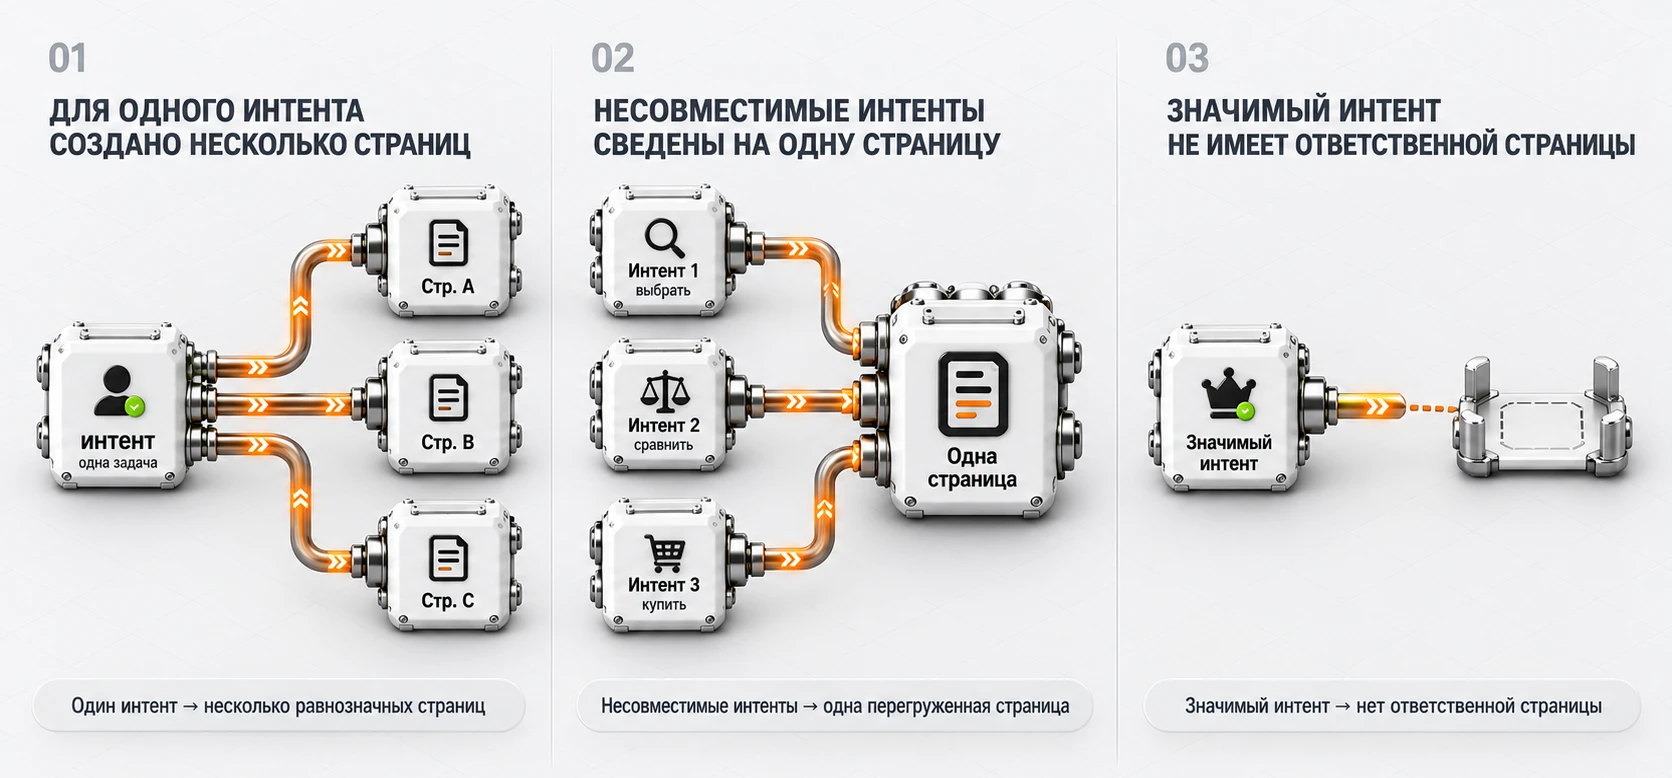
Архитектурный конфликт возникает, когда один интент распределён между несколькими страницами, одна страница перегружена несовместимыми интент или значимая задача остаётся без ответственного документа.
Как архитектурные ошибки создают каннибализацию?
Каннибализация возникает не из самого факта, что несколько страниц связаны с одной темой. Для сложного смыслового объекта это нормально: коммерческая страница, инструкция, сравнение и кейс могут быть релевантны разным задачам.
Архитектурный риск появляется, когда поисковая система получает несколько документов с неразличимой ответственностью. У них совпадает основной интент, пересекается содержание, нет очевидной главной страницы, а внутренние сигналы не объясняют разницу.
В диагностике полезно различать три конфликта.
Три архитектурных конфликта
| Конфликт | Что происходит | Возможное проявление |
|---|---|---|
| Дублирование роли | Один интент распределён между несколькими равнозначными страницами | По запросам показываются разные URL, позиции нестабильны |
| Перегрузка роли | Одна страница пытается закрыть несколько несовместимых интентов | Документ ранжируется фрагментарно и не соответствует части выдачи |
| Пробел роли | Значимый интент не получил подходящей страницы | По задаче показывается общий или случайный URL либо сайт не участвует в выдаче |
Смена ранжирующегося URL сама по себе не доказывает каннибализацию. Она может зависеть от формулировки запроса, региона, устройства, изменений выдачи и других условий. Вывод требует сопоставить группу запросов, динамику посадочных страниц, содержание документов, их роли и состав результатов поиска.
Яндекс Вебмастер позволяет анализировать данные в разрезах запросов и URL, в том числе видеть страницы, которые отображаются по выбранным запросам. Аналогичное сопоставление выполняется по данным Google Search Console. Эти данные показывают наблюдаемое поведение, но архитектурная причина устанавливается только после проверки содержания и отношений между страницами.
В рамках этой статьи важно зафиксировать происхождение проблемы: каннибализация часто начинается до написания текстов и настройки ссылок — в момент, когда один интент получает несколько ответственных URL. Способы объединения, разведения или переназначения страниц требуют отдельной диагностики и рассматриваются отдельно.
Как внутренняя перелинковка выражает архитектуру?
Внутренние ссылки выполняют в архитектуре три функции.
Обнаружение. Ссылка создаёт путь к документу. Это особенно важно для страниц, которые нельзя найти через форму поиска, фильтр или другой интерактивный интерфейс.
Контекст. Анкор и окружающий текст объясняют, что находится на целевой странице и зачем к ней переходить. Поисковые системы рекомендуют делать текст ссылки описательным, кратким и релевантным обеим связанным страницам.
Приоритет. Система ссылок показывает, какие документы выступают центрами тем и какие страницы их поддерживают. Ссылка из статьи на услугу может связывать объяснённую проблему с коммерческим решением, а ссылка из категории на карточку — группу с конкретным объектом.
Но ссылка не способна назначить корректную роль странице, если содержание ей противоречит. Если две посадочные страницы одинаково претендуют на одну услугу, несколько дополнительных ссылок на выбранный URL могут усилить его относительную заметность, но не устранят смысловое дублирование. Если категория создана без самостоятельного интент, анкор с ключевой фразой не сделает её необходимой пользователю.
Поэтому перелинковка проектируется после определения ролей или одновременно с ними. Сначала устанавливается, какие отношения действительно существуют, затем выбираются места и формулировки ссылок. Обратный порядок часто создаёт сеть переходов без ясной логики: страницы связаны технически, но читателю и поисковой системе непонятно, почему один документ ведёт к другому.
Количество ссылок также нельзя оценивать вне контекста. Google не устанавливает «магического» идеального числа ссылок на странице. Для архитектуры важнее, ведут ли они к полезным связанным документам, различимы ли их назначения и соответствует ли общая система фактическим приоритетам сайта.
По каким данным можно диагностировать SEO-архитектуру?
У SEO-архитектуры нет универсального официального балла. Диагностика строится на сопоставлении нескольких слоёв данных, каждый из которых отвечает на отдельный вопрос.
Данные для диагностики SEO-архитектуры
| Источник данных | Что он показывает | Чего не доказывает сам по себе |
|---|---|---|
| Поисковый спрос | Формулировки, частотность, динамику задач | Необходимое количество страниц |
| Состав выдачи | Какие типы ответов поисковик выбирает сейчас | Единственно допустимую структуру сайта |
| Search Console и Яндекс Вебмастер | Какие URL получают показы и клики по запросам | Причину выбора страницы |
| Индекс и технический обход | Доступность, статусы, canonical, внутренние пути | Правильность роли страницы |
| Контент-инвентаризация | Темы, объекты, назначение и пересечения документов | Реальный поисковый спрос |
| Граф внутренних ссылок | Связность, анкоры, центры и изолированные страницы | Смысловую корректность отношений без чтения контента |
| Бизнес-карта услуг и продуктов | Реальные предложения, ограничения, приоритеты | То, как пользователи формулируют задачи |
Смысл диагностики — не собрать максимальный объём выгрузок, а проверить соответствие между назначенной и наблюдаемой ролью страницы.
Для каждого значимого смыслового объекта сопоставляются:
- группа запросов и её основной интент;
- типы документов в выдаче;
- существующая страница, которая должна отвечать за задачу;
- URL, который фактически получает показы;
- содержание и коммерческое назначение документа;
- соседние страницы с пересекающейся ответственностью;
- входящие и исходящие внутренние связи;
- место страницы в навигации и пользовательском пути.
После сопоставления возникают не оценки «хорошо» или «плохо», а проверяемые состояния.
Роль подтверждена: назначенная страница соответствует интенту, отличается от соседних документов и фактически участвует в поиске по ожидаемой группе запросов.
Роль не выражена: страница существует, но её содержание и связи не позволяют установить основную ответственность.
Роль конфликтует: на тот же интент претендуют другие документы или назначенная страница обслуживает несовместимые задачи.
Роль отсутствует: у бизнеса есть релевантное предложение или знание, но для значимой пользовательской задачи нет подходящего документа.
Роль назначена ошибочно: страница отражает внутреннюю классификацию бизнеса, но не соответствует задаче, которую показывает спрос и выдача.
Единичный сигнал не должен превращаться в окончательный вывод. Один результат выдачи не устанавливает постоянный интент. Один «не тот» URL не доказывает каннибализацию. Большое число внутренних ссылок не делает страницу основной, если она не представляет нужный смысловой объект. Диагностическое заключение появляется только там, где сходятся данные о спросе, содержании, фактической видимости и отношениях между документами.
Какие решения бизнес получает из архитектурной диагностики?
Архитектурная диагностика должна завершаться не схемой ради схемы, а решениями о составе и ответственности страниц.
Основных типов решений несколько.
Сохранить роль. Страница соответствует задаче, занимает понятное место и не конфликтует с соседними документами. Изменения могут касаться содержания или ссылок, но архитектурное назначение остаётся прежним.
Уточнить роль. Документ нужен, однако его объект, основной интент или границы выражены недостаточно ясно. Тогда корректируются содержание, заголовки, навигационное представление и связи.
Разделить роли. Одна страница обслуживает разные задачи, для которых пользователи ожидают разные типы ответа. Разделение оправдано только при наличии самостоятельных смысловых объектов и достаточного содержания, а не ради увеличения числа URL.
Объединить роли. Несколько страниц отвечают на одну задачу и не имеют устойчивых различий. Тогда выбирается основной документ, а содержание и сигналы консолидируются в соответствии с конкретной ситуацией.
Создать недостающую роль. Спрос и предложение бизнеса пересекаются, но подходящей страницы нет. Новый документ получает заранее определённые объект, интент, границы и связи.
Изменить иерархию. Роли страниц в целом корректны, но система не показывает, какая из них основная, какие частные и какие поддерживающие. Тогда пересматриваются навигация, контекстные ссылки и пути между документами.
Для бизнеса это означает более точное управление инвестициями в сайт. Команда понимает, какие страницы нужны не потому, что «конкуренты так делают», а потому, что у них есть отдельная функция. Становится видно, где новый контент расширит поисковое покрытие, а где лишь создаст ещё одного претендента на существующий интент.
Архитектура не гарантирует позиции: на видимость влияют качество ответа, конкурентность, авторитетность, техническое состояние и другие факторы. Но без распределённой ответственности невозможно последовательно работать ни с релевантностью, ни с каннибализацией, ни с внутренними ссылками. Эти инструменты начинают давать управляемый результат только тогда, когда понятно, какую систему страниц они должны поддерживать.
Заключение
Сильная SEO-архитектура начинается не с меню, URL или внутренней перелинковки. Сначала нужно определить, какие пользовательские задачи сайт должен представлять и какой документ отвечает за каждую из них.
Когда ответственность страниц распределена, техническая структура и ссылки начинают выражать уже существующую смысловую систему. Если роли не определены, те же инструменты лишь маскируют конфликт: несколько страниц продолжают претендовать на одну задачу или значимый интент остаётся без подходящего документа.
На этой основе можно переходить к следующим уровням: устранять SEO-каннибализацию, проектировать внутреннюю перелинковку и строить граф контента. Без архитектурной модели эти действия остаются локальными правками, в то время как с ней становятся частью единой системы поискового представления бизнеса.